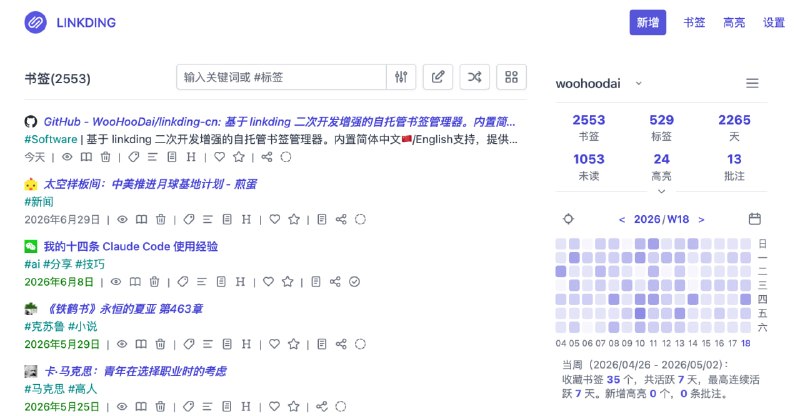
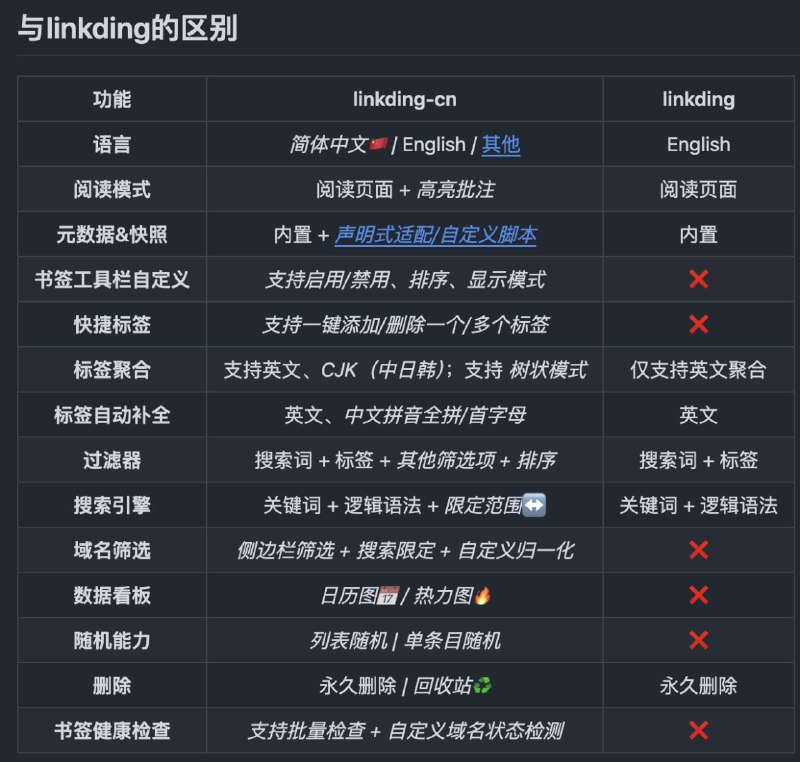
折腾啥linkding-cn: 开源自托管的书签管理与稍后读工具21:02 · 2026年10月14日 · 周三 × × linkding-cn: 开源自托管的书签管理与稍后读工具基于 linkding 二次开发• 自动保存网页元数据、Favicon 与 HTML 快照,支持站点适配规则和自定义抓取脚本• 提供可定制阅读模式,支持正文提取、高亮批注及阅读主题配置• 内置标签筛选、逻辑搜索、数据看板、随机浏览与书签健康检查https://github.com/WooHooDai/linkding-cn 合集 群组 恰饭 联系推广#书签管理 #稍后读 #自托管 #网页存档 #Docker #GitHub21:02 · 2026年10月14日 · 周三书签管理稍后读自托管网页存档DockerGitHub
折腾啥Reader: 面向 LLM Agent 的开源生产级 Web 抓取与爬取引擎18:01 · 2026年2月14日 · 周六Reader: 面向 LLM Agent 的开源生产级 Web 抓取与爬取引擎• 内置 Cloudflare/Turnstile 等反爬绕过能力,包含 TLS 指纹、DNS over TLS、WebRTC 掩蔽 • 抓取后直接输出干净的 Markdown/HTML,自动抽取正文并清理导航栏、弹窗、Cookie 横幅等噪音 • 同时提供 CLI 与 Node.js API,支持并发批量抓取、站点 BFS 爬取、浏览器池与代理轮换用于稳定上线 https://github.com/vakra-dev/reader#网页抓取 #网络爬虫 #LLM #Agent #Cloudflare #Nodejs #CLI #Proxy #GitHub #开源工具 #生产环境18:01 · 2026年2月14日 · 周六❤️4网页抓取网络爬虫LLMAgentCloudflareNodejsCLIProxyGitHub开源工具生产环境
折腾啥Sub-Store 获取套了 CF 的网页上的订阅18:01 · 2025年12月28日 · 周日Sub-Store 获取套了 CF 的网页上的订阅本来想示范下怎么抓套 CF 的订阅的 但是好像没啥意义 一般换代理 App 的 UA 就行...那就示范下怎么抓套了 CF 的网页吧新增订阅的弹窗里 选 导入 然后导入此 JSON 文件 修改注释说明的地方即可使用的是 https://github.com/FlareSolverr/FlareSolverr如果有其他需求 用 AI 改吧 Sub-Store 合集 频道资源合集 恰饭推荐 群组 #Sub-Store #SubStore #脚本 #节点 #订阅 #爬虫 #免费 #白嫖 #网页 sub-store_subscription_flaresolverr_2025-12-25_21-06-11.json 1.8 KB 18:01 · 2025年12月28日 · 周日❤️4👍3SubSubStore脚本节点订阅爬虫免费白嫖网页
折腾啥Sub-Store 抓取网页中的订阅示例16:48 · 2025年8月6日 · 周三 × × Sub-Store 抓取网页中的订阅示例示范一下如何抓其实这个 repo 里的不需要爬虫...因为它的链接其实有规律 变量就是日期 anyway...演示一下怎么抓了之后下载解析如图 1 导入 评论区的文件开嫖图 2 流量订阅信息是乱写的 娱乐一下🆕 新增示范 获取套了 CF 的网页上的订阅 Sub-Store 合集 频道资源合集 恰饭推荐 群组 #Sub-Store #SubStore #脚本 #节点 #订阅 #爬虫 #免费 #白嫖 #网页16:48 · 2025年8月6日 · 周三❤️3👍1SubSubStore脚本节点订阅爬虫免费白嫖网页
 Sub-Store 合集
 频道资源合集
 恰饭推荐
 群组
 #Sub-Store #SubStore #脚本 #节点 #订阅 #爬虫 #免费 #白嫖 #网页

 Sub-Store 合集 频道资源合集 恰饭推荐 群组 #Sub-Store #SubStore #脚本 #节点 #订阅 #爬虫 #免费 #白嫖 #网页